某企业自建NVIDIA RTX4090GPU大模型深度学习案例
基于NVIDIA RTX 4090的深度学习与大模型训练建设方案
一、项目背景与建设目标
随着大模型(LLM、VLM)在自然语言处理、计算机视觉、科学计算等领域的广泛应用,对本地化、高性价比算力平台的需求日益增长。当前,云端GPU资源虽然强大,但存在成本高、数据隐私风险、网络延迟大等问题,尤其对高校实验室、初创企业及独立研究者而言,长期使用云服务负担沉重。NVIDIA RTX 4090凭借其24GB GDDR6X大显存、高达83 TFLOPS的FP16算力以及消费级产品的高性价比,成为构建本地大模型训练与推理平台的理想选择。其强大的单卡性能不仅支持主流大模型的推理任务,通过多卡协同还能实现参数高效的微调训练。本方案旨在构建一套以RTX 4090为核心的高性能深度学习工作站或可扩展集群,支持从7B到70B参数级大模型的微调、推理与本地化部署,满足科研、教学与产品开发的多样化需求,实现“本地炼丹、高效迭代、数据安全”的核心目标。
二、建设原则
l 极致性价比:采用消费级旗舰GPU,大幅降低大模型研发的硬件门槛,避免依赖昂贵的专业卡。
l 大显存优先:24GB显存可支持14B模型全精度推理,70B模型通过4-bit量化也可运行,显著提升实用性。
l 多卡协同:支持双卡、四卡甚至八卡并行训练,利用模型并行、数据并行和流水线并行提升吞吐能力。
l 扩展性强:平台支持NVMe SSD高速存储、大容量内存、100GbE/InfiniBand网络接入,便于未来升级。
l 易用性高:预置主流AI框架与容器化环境,支持Docker、Kubernetes部署,降低使用者的技术门槛。
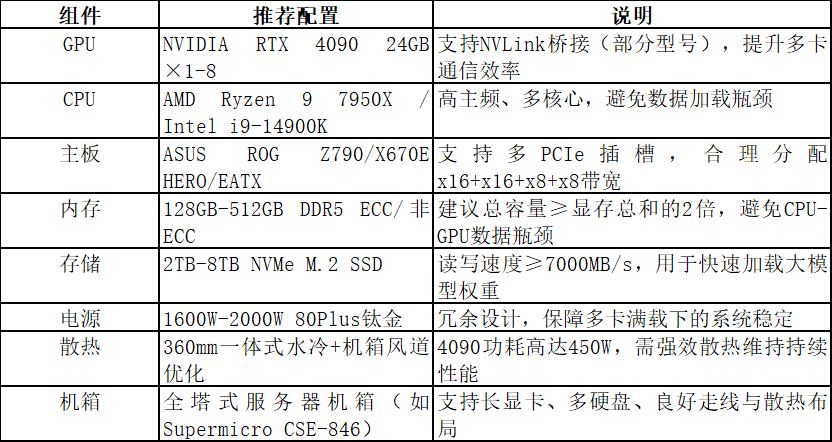
三、硬件配置方案
四、网络拓扑与互联架构
由于RTX 4090不支持NVLink全互联,多卡通信依赖PCIe Switch或CPU提供的PCIe通道。建议采用“CPU中心化拓扑”,通过BIOS设置实现PCIe带宽均衡分配,避免带宽瓶颈。
l 单机多卡拓扑:CPU作为中心节点,通过PCIe 5.0 x16通道连接PCIe Switch,再分出多路PCIe 4.0 x16通道连接各张4090,实现卡间P2P通信。
l 多机集群拓扑(可选):通过100Gbps以太网或InfiniBand网络连接多台4090工作站,构建分布式训练集群,支持DeepSpeed等框架的跨节点并行。
l RDMA支持:配置RoCEv2网络协议,结合支持GPU Direct RDMA的网卡,实现跨节点显存直接访问,显著降低通信延迟。
五、软件栈与环境配置
l 操作系统:Ubuntu 22.04 LTS(推荐)或 Windows 11 + WSL2,提供稳定内核与良好驱动支持。
l 驱动与CUDA:NVIDIA Driver 535+,CUDA 12.2+,cuDNN 8.9+,确保对新特性的完整支持。
l 深度学习框架:
n PyTorch 2.1+:支持FlashAttention、FSDP、compile等优化特性
n TensorFlow 2.13+:兼容传统CV与语音任务
l 大模型工具链:
n HuggingFace Transformers:主流模型统一接口
n Accelerate、DeepSpeed:支持ZeRO-3、模型并行、混合精度训练
n vLLM:高性能推理引擎,提升吞吐与显存利用率
n llama.cpp:支持GGUF量化,可在CPU/GPU协同下运行大模型
l 量化支持:集成bitsandbytes(4-bit/8-bit)、GPTQ、AWQ等量化技术,使70B模型可在单机运行。
六、典型应用场景支持
l7B-13B模型:可进行全精度推理与LoRA微调,响应速度快,适合对话系统开发。
l32B模型:通过8-bit量化可实现推理,结合QLoRA可进行轻量微调。
l70B模型:使用4-bit量化(如GPTQ/AWQ)可在单机运行,支持本地知识库问答。
l多模态模型:支持LLaVA、Qwen-VL等视觉语言模型的训练与推理。
lAI绘画与生成:支持Stable Diffusion XL、Midjourney本地部署,实现文生图、图生图等任务。
七、部署实施路径
l阶段一:单机双卡验证:部署2×4090工作站,验证多卡并行、显存分配与通信效率,测试主流框架兼容性。
l阶段二:四卡/八卡训练节点:构建单机8卡服务器,部署大内存与高速存储,支持70B模型量化微调。
l阶段三:集群化扩展:通过100Gbps网络连接多个节点,部署分布式训练框架,提升算力上限。
l阶段四:平台化管理:集成Kubernetes + KubeFlow,实现资源调度、用户隔离、任务队列与计费系统。
八、运维与安全保障
l监控系统:部署Prometheus + Grafana,实时监控GPU利用率、显存占用、温度与功耗。
l数据安全:本地存储为主,定期备份至NAS或云存储,支持RAID 1/10防止单点故障。
l访问控制:SSH密钥登录、用户权限分级、防火墙策略,防止未授权访问。
l自动告警:设置显存溢出、温度过高、任务崩溃等事件的邮件/钉钉通知机制。
九、预期成效
l算力水平:单卡FP16算力83 TFLOPS,8卡集群理论算力达664 TFLOPS,接近专业卡集群水平。
l模型支持:支持从7B到70B全系列大模型本地化运行,满足多数科研与工程需求。
l训练效率:相比单卡提升5~7倍,结合QLoRA可在消费级平台完成高效微调。
l成本优势:相比A100/H100方案,建设成本降低60%以上,运维成本几乎为零。
十、总结
本方案以RTX 4090为核心,构建高性价比、易维护、可扩展的本地大模型计算平台,助力科研机构与开发者实现“算力自主、模型可控、迭代高效”的AI研发目标,是当前大模型时代极具竞争力的本地化解决方案。
上一页:大湾区GPU科学计算 | 下一页:某医院医学影像AI推理平台
 售前咨询专员