英伟达Vera Rubin平台量产交付:AI服务器竞争转向“每兆瓦算力”
10 月 12 日,在 2026 年 OCP 全球峰会上,联想宣布已开始在全球范围内交付英伟达新一代 Vera Rubin NVL72 机架级 AI 系统,并将完整的 Vera Rubin 平台纳入其 AI 云超级工厂解决方案。几乎同期,AI 云服务商 CoreWeave 宣布该系统已在其云平台正式投入生产,AI 软件公司 Cognition 成为首个在该平台运行生产负载的客户。这意味着英伟达下一代整柜平台已经从发布走向真实业务,AI 服务器的竞争指标也随之改写。
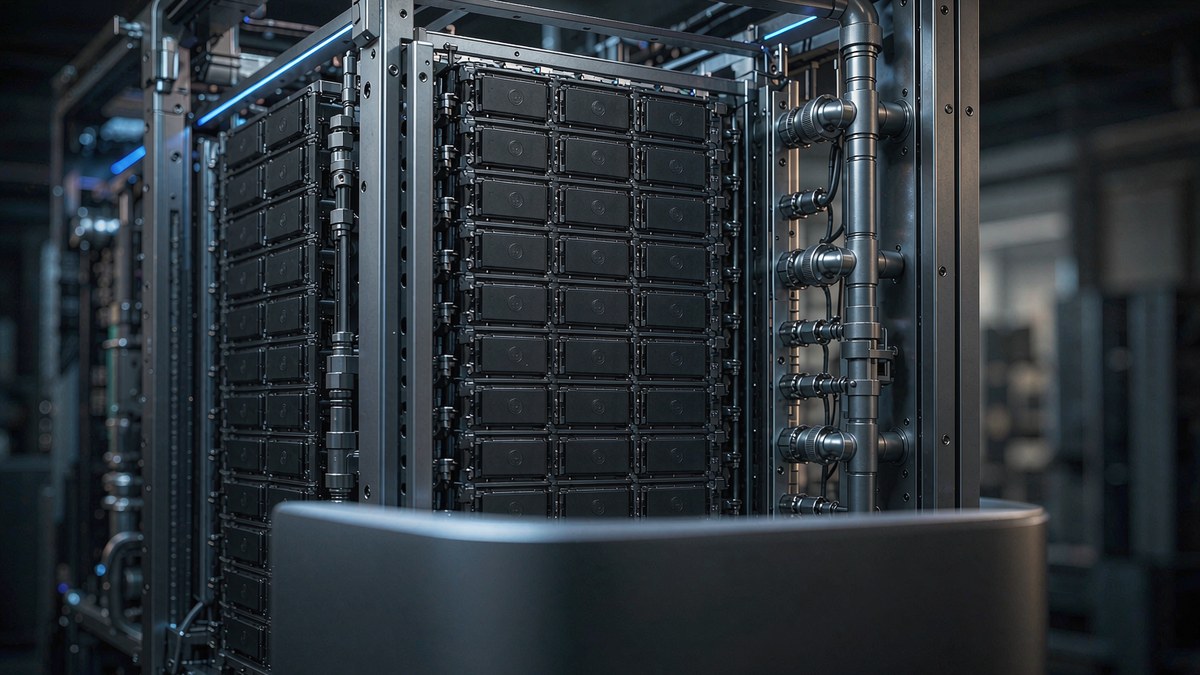
一、Vera Rubin NVL72:一颗机柜里的 72 颗 GPU
Vera Rubin 是英伟达面向下一代 AI 训练、推理及智能体计算推出的全新平台。NVL72 系统集成 72 颗 Rubin GPU 与 36 颗 Vera CPU,采用 NVLink 6 高速互连技术,官方给出的数据是:每兆瓦吞吐量最高可提升 30 倍。
与过去只交付 GPU 不同,这次是五大机架级系统整合为一体交付:Vera Rubin NVL72、Groq 3 LPX 推理加速系统、Vera CPU 机架、CMX 上下文存储平台以及 Spectrum-6 网络系统,形成覆盖计算、推理、存储与网络的完整架构。
二、实测数据:整柜效率成为新标尺
CoreWeave 公布的实测结果显示,Vera Rubin NVL72 的总 Token 吞吐量较 GB200 NVL72 最高提升 4.8 倍;在强化学习场景中,每 GPU 输出 Token 吞吐量达到 GB200 NVL72 的 3.8 倍。这组数字的意义在于,评价一套 AI 基础设施的标尺,正从“单卡峰值算力”转向“单位电力能产出多少有效 Token”。
对机房运营方来说,这个变化非常直接:过去比的是谁的 GPU 多,现在比的是谁的每兆瓦有效算力高。供电、散热、网络、存储中任何一环拖后腿,都会摊薄整柜的实际产出。
三、竞争从“芯片”转向“系统工程”
业内的共识是,AI 竞赛已经不再只关乎 GPU 部署,而在于云服务商能以多快的速度,把电力、空间和基础设施投资转化为实际运营的算力与收入。单卡性能再强,如果不能在数月内完成从设备到货到算力上线的全流程部署,就无法转化为真实的算力和收入。
这也解释了为什么整机厂与系统集成商的角色在变重:整柜方案需要机柜结构、液冷歧管、供电分配、漏液检测、机架级管理软件的整体设计能力,而不是简单地把 GPU 插到主板上。
四、对现有平台用户的两点提示
第一,新建智算中心应按“整柜”预留电力和制冷余量,至少为下一代平台留出升级空间,避免刚建成就要改造。
第二,已有的 GB200、GB300 平台并不会因为新平台出现而立刻失去价值。通过集群调度优化、提高上机率、把推理与训练负载分开编排,存量算力依然可以在很长时间里贡献产出。技术迭代是渐进的,把折旧周期算清楚比追新更重要。
信息来源:2026 年 OCP 全球峰会(10 月 12 日)相关发布、CoreWeave 官方公告、联想集团新闻稿;公开报道整理。
 售前咨询专员